基于SHOX2和RASSF1A甲基化水平的机器学习算法预测早期肺腺癌病理类型
2025-09-19 中国胸心血管外科临床杂志 中国胸心血管外科临床杂志 发表于上海
本研究旨在整合 SHOX2 和 RASSF1A 的甲基化数据,开发并优化多种机器学习模型,以直接预测早期肺腺癌的病理类型。
摘 要
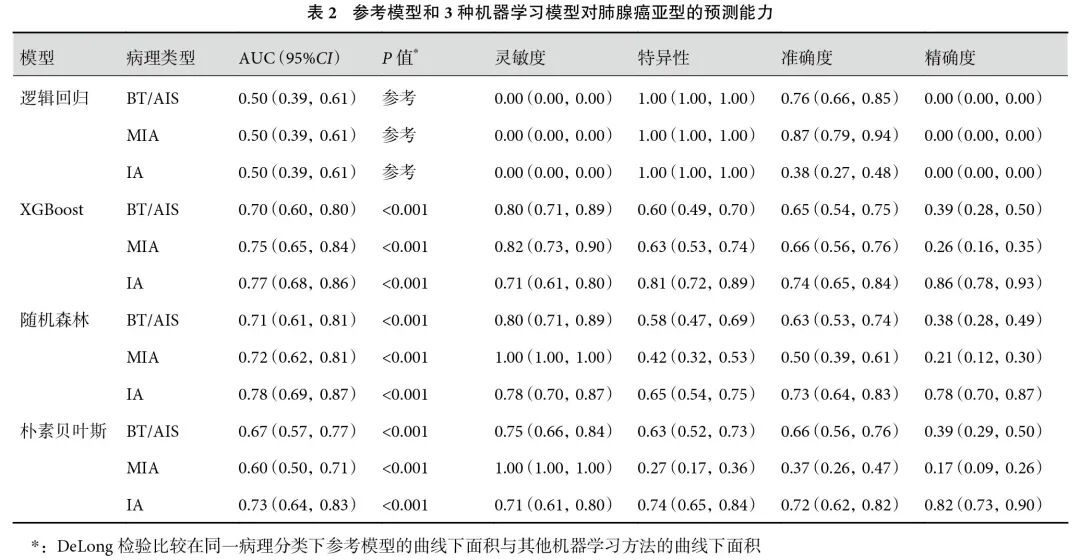
目的 探讨基于SHOX2和RASSF1A甲基化水平的机器学习算法预测早期肺腺癌病理类型的准确性。方法 回顾性分析2021年1月—2023年1月在南通大学附属医院接受肺部肿瘤切除手术患者的石蜡包埋(formalin-fixed paraffin-embedded,FFPE)标本。根据肿瘤的病理学分类,将患者分为3组:良性肿瘤/原位腺癌(benign tumor/adenocarcinoma in situ,BT/AIS)组、微浸润性腺癌(minimally invasive adenocarcinoma,MIA)组和浸润性腺癌(invasive adenocarcinoma,IA)组。使用LungMe试剂盒通过甲基化特异性PCR(MS-PCR)测量FFPE标本的SHOX2和RASSF1A甲基化水平。以SHOX2和RASSF1A的甲基化水平为预测变量,采用机器学习算法(包括逻辑回归、XGBoost、随机森林、朴素贝叶斯)预测不同的肺腺癌病理类型,并构建网络服务器供临床使用。结果 共纳入272例患者,BT/AIS组、MIA组和IA组患者的平均年龄分别是57.97岁、61.31岁和63.84岁;女性患者占比分别为55.38%、61.11%和61.36%。基于SHOX2和RASSF1A甲基化水平建立的早期肺腺癌预测模型中,随机森林与XGBoost模型在预测各病理类型时表现良好。随机森林模型的C统计量在BT/AIS组、MIA组和IA组分别为0.71、0.72和0.78。XGBoost模型的C统计量在BT/AIS组、MIA组和IA组分别为0.70、0.75和0.77。朴素贝叶斯模型仅在IA组表现较为稳健,C统计量为0.73,具有一定的预测能力。逻辑回归模型在各组中的表现最差,对各组均无预测能力。通过决策曲线分析,随机森林模型在BT/AIS和MIA病理类型的预测中展示了较高的净收益,表明其在临床应用中具有潜在价值。结论 基于SHOX2和RASSF1A甲基化水平的机器学习算法预测早期肺腺癌病理类型具有较高的准确性。
正 文
肺癌是所有癌症中死亡率最高的类型,每年导致全球 180 万人死亡[1]。肺腺癌是最常见的肺癌亚型,占所有肺癌的39%,且其发病率正在逐年上升[2-3]。早期肺腺癌的病理演变经历了从不典型腺瘤样增生(adenomatous atypical hyperplasia,AAH)到原位腺癌(adenocarcinoma in situ,AIS),再到微浸润腺癌(minimally invasive adenocarcinoma,MIA)及浸润性腺癌(invasive adenocarcinoma,IA)的过程。对于 AIS 和 MIA,肺楔形切除、肺段切除已被证明在确保治疗效果的同时,能够最大限度地保留肺功能、缩短手术时间、减少术后并发症。而对于IA,可能需要进行肺叶切除或全肺切除,且常需联合放疗、化疗以及靶向治疗[4]。因此,早期肺腺癌病理类型的准确诊断是临床决策面临的巨大挑战。低剂量计算机断层扫描(low-dose computed tomography,LDCT)具有高敏感性,有助于早期肺腺癌的检测,能够识别肺实质中的细微变化,包括一些已确定的肺腺癌典型影像表现,如毛玻璃结节。尽管LDCT筛查显著提高了早期肺癌的检测率,但由于可检出的病变尺寸变得更小,导致可切除的病变组织减少。早期病变的形态多样性使直接区分良性和恶性病变变得更加困难,并引发了过度诊断和过度治疗的问题。
近年来,表观遗传学研究的进展引起了人们对 DNA 甲基化在癌症发病机制中作用的极大关注[5-6]。大量研究[7]表明,某些特定区域的异常 DNA 甲基化是人类癌症中高度确定的表观遗传改变。这种特性不仅具有区分癌细胞与正常组织的潜力,还为其在早期癌症检测中的应用提供了可能。SHOX2基因被证实是多种癌症信号通路的调控子或效应子,可促进肿瘤的发生和发展。SHOX2基因异常高甲基化可能发生在肺癌早期并与高甲基化后该基因的失活有关[8]。RASSF1A 是一种常在多种癌症中缺失的肿瘤抑制基因。RASSF1A 已被广泛作为肺癌的辅助 DNA 甲基化生物标志物[9]。SHOX2 和 RASSF1A 甲基化检测已被证明可用于多种肿瘤的诊断,其在提高早期肺癌检测灵敏度方面的潜力得到验证[10-11]。既往研究[12]表明,SHOX2 和 RASSF1A 甲基化在早期肺腺癌检测中发挥了重要作用,特别是在区分 AIS、MIA 和 IA 方面,SHOX2 和 RASSF1A 甲基化可作为病理诊断不明确的早期肺腺癌病例的补充诊断工具。然而,传统的分类方法难以直接区分所有类型的肺腺癌,这限制了其在临床中的应用。
近年来,随着机器学习方法在处理复杂非线性关系方面表现出的显著优势,这些方法在医学领域的应用得到了广泛关注和认可。尤其是在应对各种环境和疾病条件下的复杂预测任务中,机器学习模型展示出了超越传统统计学方法的潜力,不仅能够捕捉数据中的潜在模式,还能提高疾病诊断和预测的准确性[13]。机器学习技术已成功应用于多种医学预测任务,包括癌症筛查、疾病进展预测和治疗反应评估等。然而,尽管已有许多研究[14]表明机器学习在肿瘤学领域的巨大潜力,其在早期肺腺癌病理类型预测中的应用仍需进一步探索和验证。本研究旨在整合 SHOX2 和 RASSF1A 的甲基化数据,开发并优化多种机器学习模型,以直接预测早期肺腺癌的病理类型。
1 资料与方法
1.1 临床资料和分组
回顾性分析2021年1月—2023年1月在南通大学附属医院接受肺部肿瘤切除手术患者的石蜡包埋(formalin-fixed paraffin-embedded,FFPE)标本。纳入标准:经病理证实,肿瘤组织属于肺良性肿瘤或者腺癌类型。排除标准:FFPE样本的保存时间超过2年。由于原位腺癌被归类为癌前病变,在本研究中,良性肿瘤(benign tumor,BT)与AIS被归为一类(BT/AIS)。根据肿瘤的病理学类型,将患者分为BT/AIS组、MIA组和IA组。
1.2 DNA提取和处理
使用FFPE DNA提取试剂盒(CWY009S,康为世纪,中国)裂解石蜡包埋的组织材料。在Qubit® 3.0荧光计上使用Qubit dsDNA HS Assay Kit(Life Technologies,加拿大)评估DNA浓度。随后,使用亚硫酸氢盐及Tellgen DNA Purification Kit(Tellgen,中国)处理DNA,将未甲基化的胞嘧啶转化为尿嘧啶。
1.3 DNA甲基化水平的检测
使用国家药品监督管理局批准的体外诊断试剂(LungMe,20173403354,透景,中国)测定FFPE样本中的DNA甲基化水平。亚硫酸氢盐处理后纯化的DNA采用RT-PCR仪(ABI 7500)进行MS-PCR。引物如下:SHOX2,F:5'-TTGTTTTTGGTTCGGGTT-3',R:5'-CATAACGTAAACGCCTATACTC-3';RASSF1A,F:5'-CGGGGTTCGTTTTGTGGTTTC-3',R:5'-CCATTAAATCCGTACTTCGC-3'。甲基化SHOX2、RASSF1A和β-ACTB的相应扩增通道分别为VIC、FAM和CY5。使用以下公式计算每个特定基因的甲基化水平:ΔCt=Ct−Ctβ-ACTB。ΔCt 表示目标基因的循环阈值(Ct)与参考基因(β-ACTB)循环阈值之间的差值。
1.4 模型构建
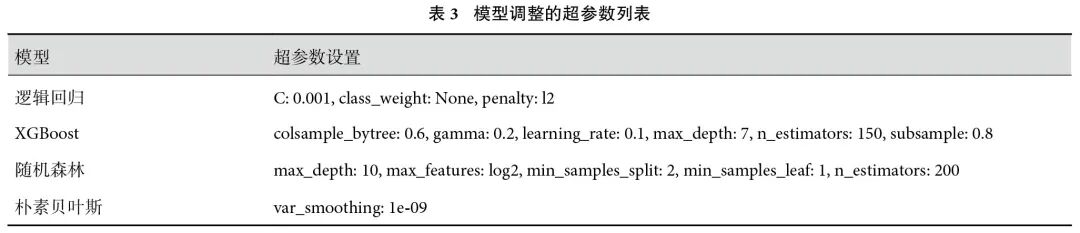
将数据随机拆分为训练集(70%的随机样本)与验证集(30%的随机样本)。在训练集中,将病理类型作为目标变量,即BT/AIS、MIA和IA,将RASSF1A和SHOX2的甲基化水平作为预测变量。首先,使用StandardScaler对预测变量进行标准化处理。由于数据集中存在类别不平衡的问题,使用SMOTE(合成少数类过采样技术)平衡类别分布。在模型开发过程中,选择4种机器学习算法:逻辑回归、XGBoost、随机森林、朴素贝叶斯。采用一对多策略(OneVsRestClassifier)执行多类别分类任务,以便将原本适用于二分类的模型扩展到多分类问题上。为优化每种模型的性能,通过使用网格搜索策略(GridSearchCV)和10折重复交叉验证选择最佳超参数组合,其中评估指标为受试者工作特征(receiver operating characteristic,ROC)曲线下面积(area under the curve,AUC)。超参数范围设置如下:逻辑回归模型中对正则化强度(C)和惩罚项(L1和L2),以及类别权重进行调优。XGBoost模型的优化则涉及学习率、树的最大深度、子采样比例和列采样比例超参数。随机森林模型的超参数优化包括决策树的数量、最大深度、最大特征数。朴素贝叶斯模型则调优了平滑参数。以上数据预处理及模型本身封装在管道(pipeline)中,最后将训练好的最佳模型保存为可重用的模型文件,以供后续分析使用。在测试集中,通过C统计量(即AUC)、灵敏度(sensitivity)、特异性(specificity)、准确度(accuracy)、精确度(precision)、ROC曲线与决策曲线分析评估每个模型的预测性能。ROC曲线可以提供一个初步的模型性能评估,AUC值越接近1,模型的分类性能越好。决策曲线分析通过在指定的阈值概率范围内展示模型的净收益,帮助评估模型在不同临床情境下的适用性和效用,并具有直接的临床解释意义。
1.5 统计学分析
使用Python语言进行统计学分析。符合正态分布的计量资料以均数±标准差(x±s)表示。计算各模型预测性能指标的95%置信区间(confidence interval,CI)。采用DeLong检验比较在同一病理分类下参考模型与其他机器学习方法的C统计量的差异。双侧检验水准α=0.05。
1.6 伦理审查
本研究已获得南通大学附属医院伦理委员会的批准(2022-L165),所有患者均签署知情同意书。
2 结果
2.1 纳入患者的基线特征
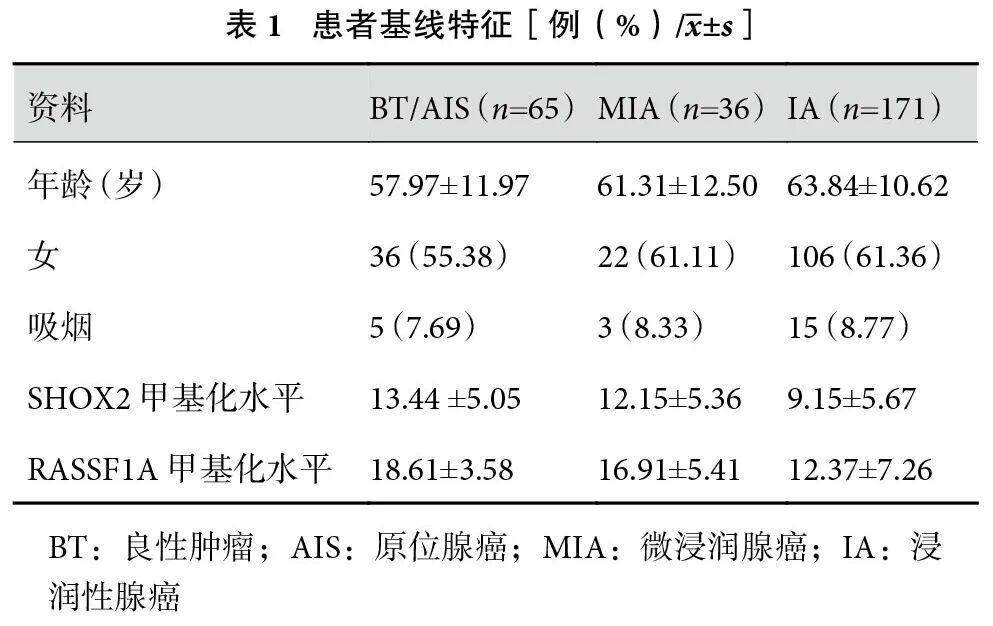
共纳入272例患者,其中171例IA、36例MIA、31例AIS和34例BT。总体上,随着病变侵袭性的增加,患者的平均年龄也有所增加。在性别分布方面,3组患者中女性比例高于男性。SHOX2与RASSF1A的甲基化水平随着肿瘤恶性程度的增加而降低;见表1。
2.2 模型的诊断效能分析及比较
逻辑回归模型对肺腺癌病理类型无区分能力,XGBoost模型与随机森林模型对3种病理类型均表现出更强的区分能力,朴素贝叶斯模型的表现略优于逻辑回归模型,其对IA的区分能力优于MIA和BT/AIS;见表2。表3显示了各模型构建所使用的超参数类型及其对应的值。ROC曲线见附图1。
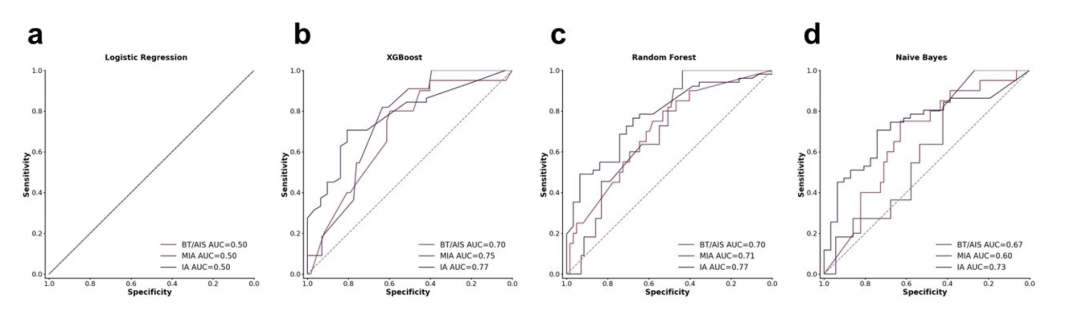
附图1 受试者工作特征曲线
a:逻辑回归模型;b:XGBoost 模型;c:随机森林模型;d:朴素贝叶斯模型
2.3 决策曲线分析
通过决策曲线分析评估随机森林模型在多分类任务中不同病理类型患者的净收益。在BT/AIS类别中,无论是XGBoost还是随机森林模型,在较广泛的阈值概率范围内均表现出较高的净收益,尤其是在<20%阈值概率时,模型表现更为优异,显示出良好的区分能力和临床适用性。在MIA类别中,XGBoost模型在14%阈值概率以下表现出显著的净收益,而随机森林模型则在低阈值范围内展现出稳定的区分能力,尽管在较高阈值时净收益有所下降。这表明在预测MIA病理类型时,两种模型均能提供一定的临床帮助,但在较高阈值范围内需要进一步优化。在IA类别中,XGBoost和随机森林模型均展现出较高的净收益,尤其是在较高阈值概率(>54%)时,两种模型的表现均优于假设所有患者均为IA的基线策略。然而,XGBoost在>70%的阈值概率,净收益略低于全部患者被分类为IA的基线策略,而随机森林模型的表现则在>45%的阈值概率仍表现出较高的预测能力。总体来看,随机森林模型在各病理类型中的表现稍优于XGBoost模型,特别是在IA类别中展现出更高的净收益。在临床应用中,这两种机器学习方法能够在不同阈值下减少误诊和漏诊,从而优化患者的治疗方案。XGBoost和随机森林模型的决策曲线图见附图2。
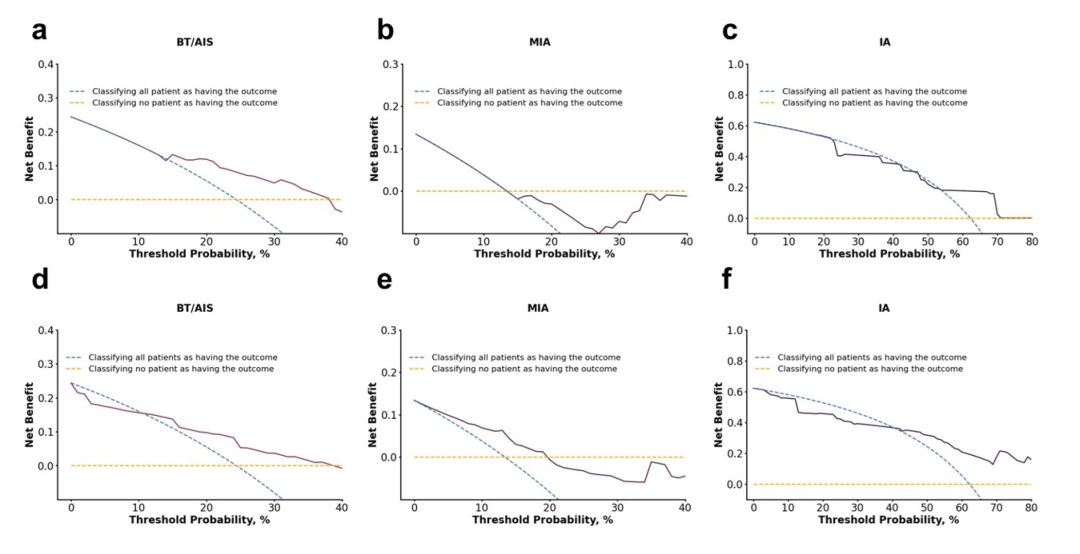
附图2 决策曲线分析
a~c:XGBoost 模型分别预测 BT/AIS、MIA 和 IA 的决策曲线分析;d~f:随机森林模型分别预测 BT/AIS、MIA 和 IA的决策曲线分析;x 轴表示预测病理类型的阈值概率,y 轴表示净收益;BT:良性肿瘤;AIS:原位腺癌;MIA:微浸润腺癌;IA:浸润性腺癌
3 讨论
不同病理类型的肺腺癌在生物学行为、预后和治疗响应上存在显著差异。IA通常需要更积极的治疗措施,MIA可能需要手术或联合放化疗切除,AIS则只需手术切除,良性肿瘤无需治疗或在必要时进行手术切除。IA往往预后较差,需要密切监测和长期管理;而MIA或AIS通常预后较好,治疗后复发的风险较低。通过准确的病理分型可以避免对低风险患者过度治疗,减少患者的治疗负担以及不必要的手术风险和并发症。因此,对早期肺腺癌进行病理类型诊断具有重要的临床意义。
LDCT的广泛应用显著促进了肺腺癌的早期发现。尽管LDCT具有高灵敏度,能够识别大量较小的早期病变,但早期病变的形态多样性和复杂性也增加了区分良性和恶性病变的难度。近年来,DNA甲基化改变作为癌症早期预后指标的潜力日益受到关注。SHOX2 的表达在大多数癌症类型中显著升高。通过对肺癌和正常组织中 SHOX2 甲基化的比较分析,观察到 96% 的肿瘤组织表现出甲基化水平升高[15]。此外,SHOX2 高表达或低甲基化表明分化较差且预后不良[8]。RASSF1A 的启动子区在 63% 的非小细胞肺癌细胞中表现出高甲基化,而在正常上皮细胞中不受影响[16]。此外,RASSF1A 甲基化水平可以预测接受培美曲塞化疗的非小细胞肺癌患者的病情进展[17]。在肺癌早期诊断中,SHOX2和RASSF1A基因的甲基化联合检测已被证明具有较高的敏感性和特异性[10-11]。研究[18]表明,SHOX2和RASSF1A甲基化水平与早期肺腺癌中Ki-67的表达呈正相关。Ki-67是癌细胞增殖的标志物,较高的Ki-67值意味着肿瘤生长和发展加速,最终导致患者预后较差[19-20]。因此,SHOX2和RASSF1A甲基化阳性可能暗示患者的肿瘤将更快进展。此外,有研究[21]报道,RASSF1A与肺癌高侵袭性之间存在显著相关性。RASSF1A基因的抑制能够促进肺癌细胞的侵袭和迁移。因此,肿瘤的侵袭性与SHOX2和RASSF1A甲基化阳性率呈正相关,即侵袭性越高,阳性率越高。我们采用SHOX2和RASSF1A基因的甲基化水平作为标志物,通过分析手术组织样本,优化了这些标志物的临界值。SHOX2和RASSF1A联合检测的AUC值在区分IA和BT时为0.814,在区分癌症组(IA和MIA)和非癌症组(AIS和BT)时为0.770,均超过0.75的阈值,进一步确认了其在早期肺腺癌诊断中的应用价值[12]。然而,传统的分类方法无法直接区分所有类型的肺腺癌,这限制了其临床应用前景。
本研究的目的在于展示机器学习模型在肺腺癌病理类型诊断中的显著优势。通过整合SHOX2和RASSF1A的甲基化数据,我们开发并优化了多种机器学习模型,能够直接预测肺腺癌的3种病理类型。相比于线性机器学习算法如逻辑回归和朴素贝叶斯,非线性机器学习算法如随机森林和XGBoost在肺腺癌病理分型的预测中展现出更高的特异性和阳性似然比。逻辑回归和朴素贝叶斯算法具有简单且容易理解的特点,其输出可以解释为事件发生的概率,这种解释性在许多实际应用中非常有用[22-23]。然而,预测变量与目标变量之间的线性关系在临床实际中可能不成立,导致线性模型可能无法准确建模。非线性模型(如XGBoost、随机森林)能够处理预测变量之间的高阶非线性交互作用,这是传统建模方法(如逻辑回归模型)难以实现的[24-25]。随机森林模型在预测肺部肿瘤的病理分型方面达到了更高的特异性和阳性似然比,从而减少了不必要的侵入性活检,可能会减少误诊率和过度治疗的风险。此外,在决策曲线分析中,机器学习方法在考虑假阴性(未检测到实际存在的腺癌)和假阳性(误诊为腺癌的良性病变)影响的情况下表现出了更高的净收益。
尽管与传统方法相比,机器学习方法的预测能力更优,但其预测能力仍然存在一定的局限性。可能的原因包括RASSF1A和SHOX2甲基化水平与肺腺癌病理分型之间的关系可能受其他尚未被纳入模型的重要生物标志物的影响。这些未纳入的标志物可能与肺腺癌的发生和进展密切相关,但由于当前模型输入变量的限制,这些标志物未能被充分捕捉和利用,导致模型预测能力的潜在局限性。此外,甲基化水平的测量可能存在一定的变异性,这种生物测量误差可能进一步影响模型的准确性。再者,尽管机器学习方法能够处理复杂的数据模式,但其对数据质量和数量的依赖性较强。如果训练数据集不足或存在噪声,这可能会限制模型的泛化能力,尤其是在处理新数据时。因此,尽管机器学习方法展示了显著的预测优势,但在实际应用中仍需谨慎考虑模型的局限性和改进方向,如整合更多维度的数据或开发更为复杂的模型结构。
在早期肺腺癌病理类型数据分析中,基于RASSF1A和SHOX2甲基化水平的机器学习算法显著提升了预测肺腺癌病理类型的准确性,相较于传统的分诊方法具有更高的区分能力。机器学习算法增强了临床医师在肺部肿瘤病理分型决策中的能力,从而避免对非高风险患者的过度治疗,进而实现更精准的临床护理和资源配置。
利益冲突:无。
作者贡献:刘益飞负责论文设计、审阅与修改,技术支持;史加海负责论文审阅与修改,资金支持和监督;黄润棋负责数据收集、整理,论文初稿撰写;强光亮负责数据整理、分析及可视化,论文讨论和修订。所有作者均已阅读稿件最终版并同意发表。
 分享
本网站所有内容来源注明为“梅斯医学”或“MedSci原创”的文字、图片和音视频资料,版权均属于梅斯医学所有。非经授权,任何媒体、网站或个人不得转载,授权转载时须注明来源为“梅斯医学”。其它来源的文章系转载文章,或“梅斯号”自媒体发布的文章,仅系出于传递更多信息之目的,本站仅负责审核内容合规,其内容不代表本站立场,本站不负责内容的准确性和版权。如果存在侵权、或不希望被转载的媒体或个人可与我们联系,我们将立即进行删除处理。
在此留言


#肺腺癌# #SHOX2#
72 举报